История успеха · AI-чат на abliterated-моделях · Весь мир
Submissive AIЧетверо запустили AI-продукт за 9 недель от идеи, на своём инференсе на 60%+ дешевле API-провайдеров
Submissive AI — чат с оплатой по использованию на abliterated-моделях, то есть open-weight-моделях со снятыми отказами, и на наших собственных дообученных моделях, для red team и профессиональной работы. Меня наняли CTO по подписке, чтобы запустить продукт, и от идеи до запуска прошло 9 недель. Я спроектировал всю систему и движок инференса и отвечаю за распределённые дата-центры, биллинговые пайплайны и стоимость инференса: наш инференс на 60%+ дешевле, чем у API-провайдеров, а загрузка GPU держится выше 80%. Четыре человека делают то, для чего обычно нужны отдельные ML-, инфраструктурная и биллинговая команды.
- Клиент
- Submissive AI
- Продукт
- AI-чат на abliterated-моделях с оплатой по использованию
- Для чего
- Red team и профессиональная работа
- Моя роль
- CTO по подписке, нанят запустить продукт
- Команда
- 4 человека
- От идеи до запуска
- 9 недель
- Инференс
- На 60%+ дешевле, чем у API-провайдеров, загрузка GPU 80%+
В цифрах
- от идеи до запуска одного из самых сложных видов AI-продукта
- 9 недель
- экономии на инференсе против API-провайдеров, на своём движке
- 60%+
- загрузка GPU: железо, за которое мы платим, почти всё время в работе
- 80%+
- человека делают работу отдельных ML- и инфраструктурных команд
- 4
- моделей: open-weight abliterated и наши дообученные
- 2 вида
- стран с нашими дата-центрами, нагрузка перетекает между ними
- Несколько
Продукт
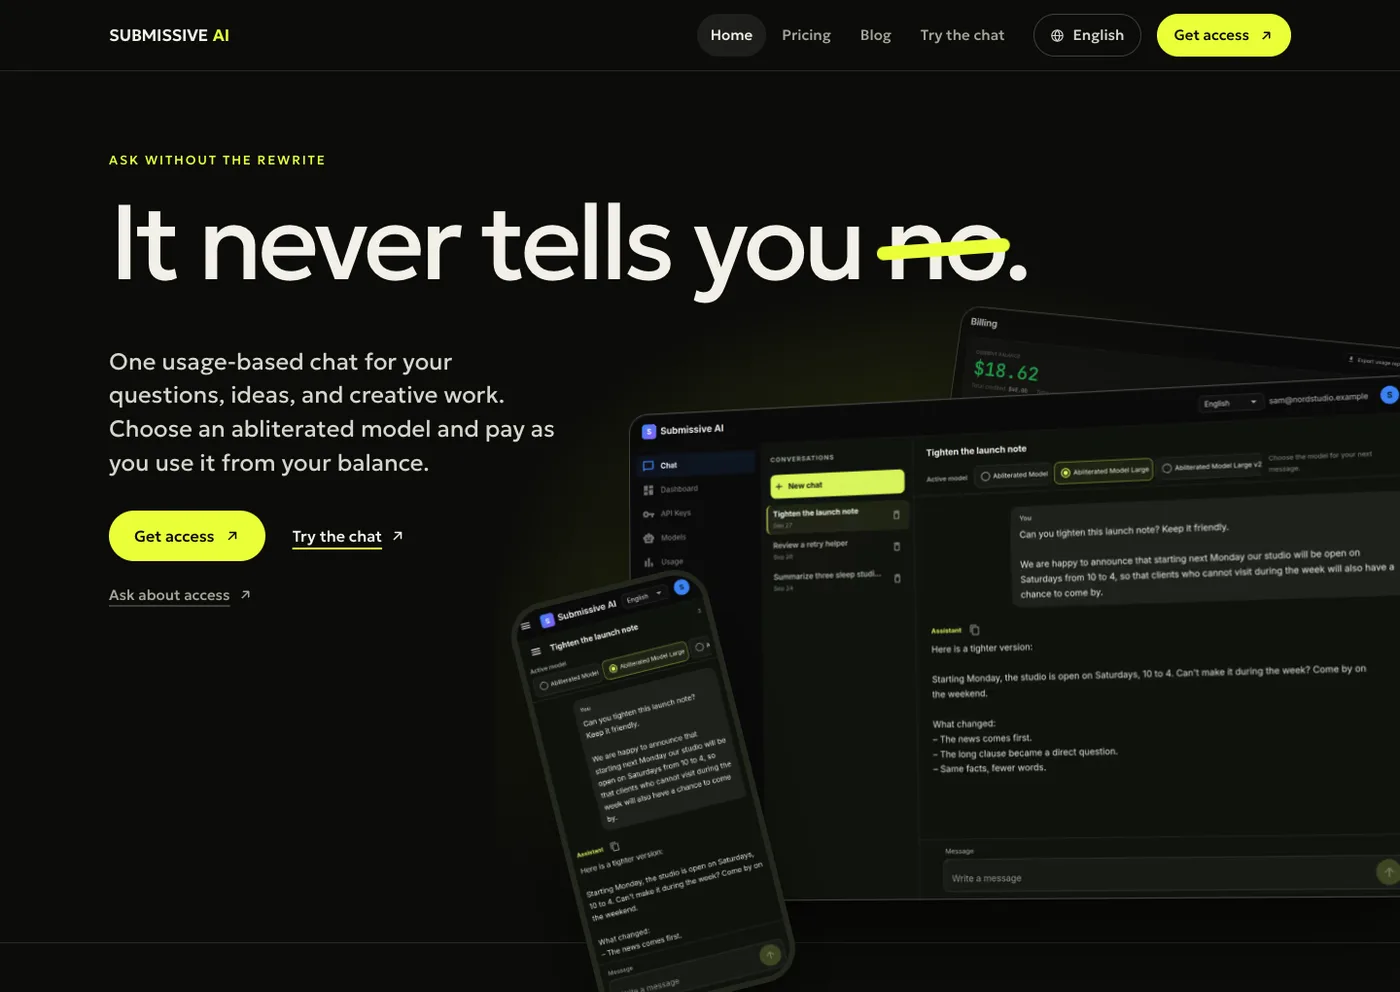
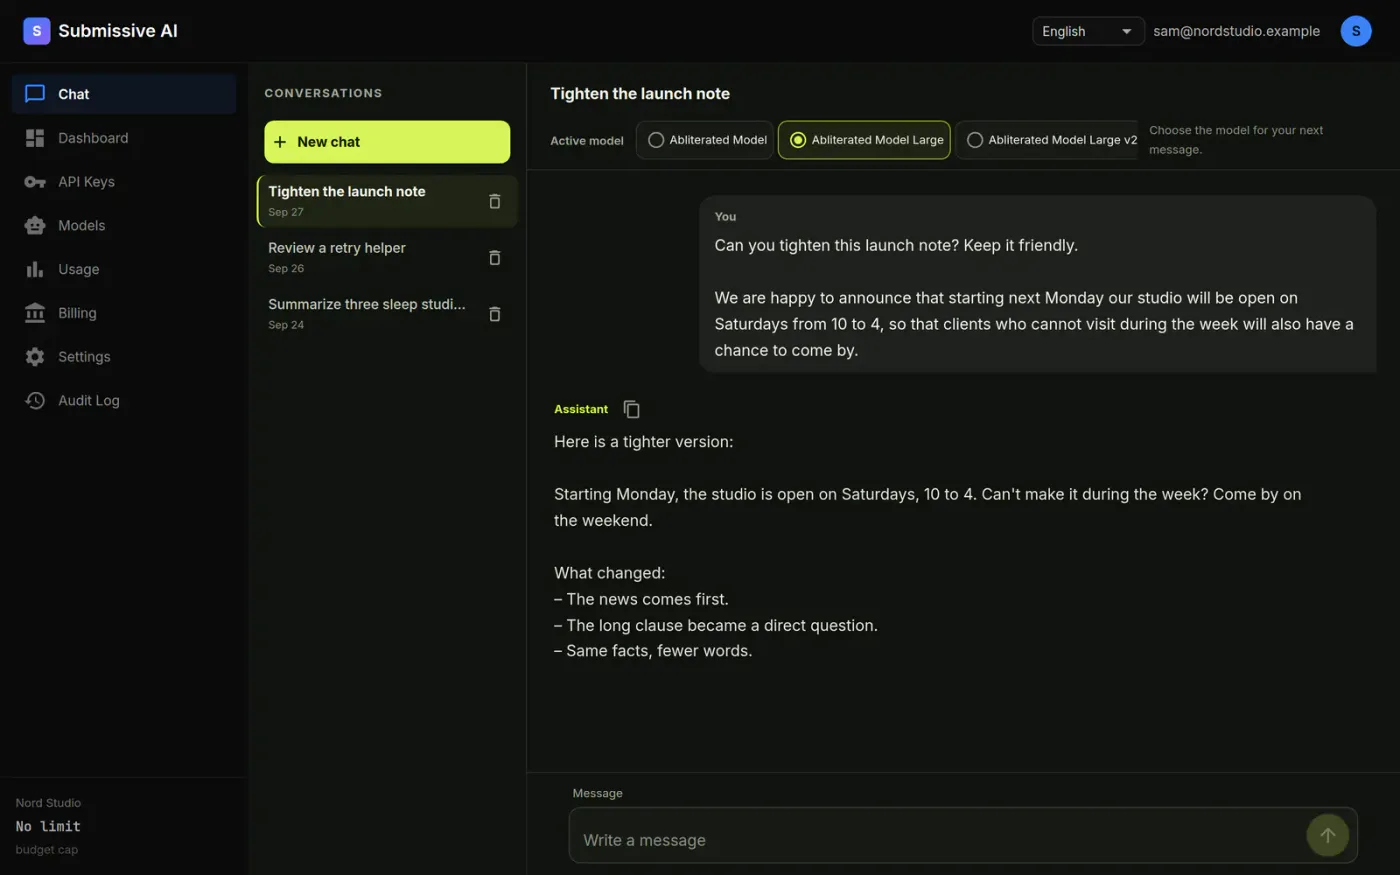
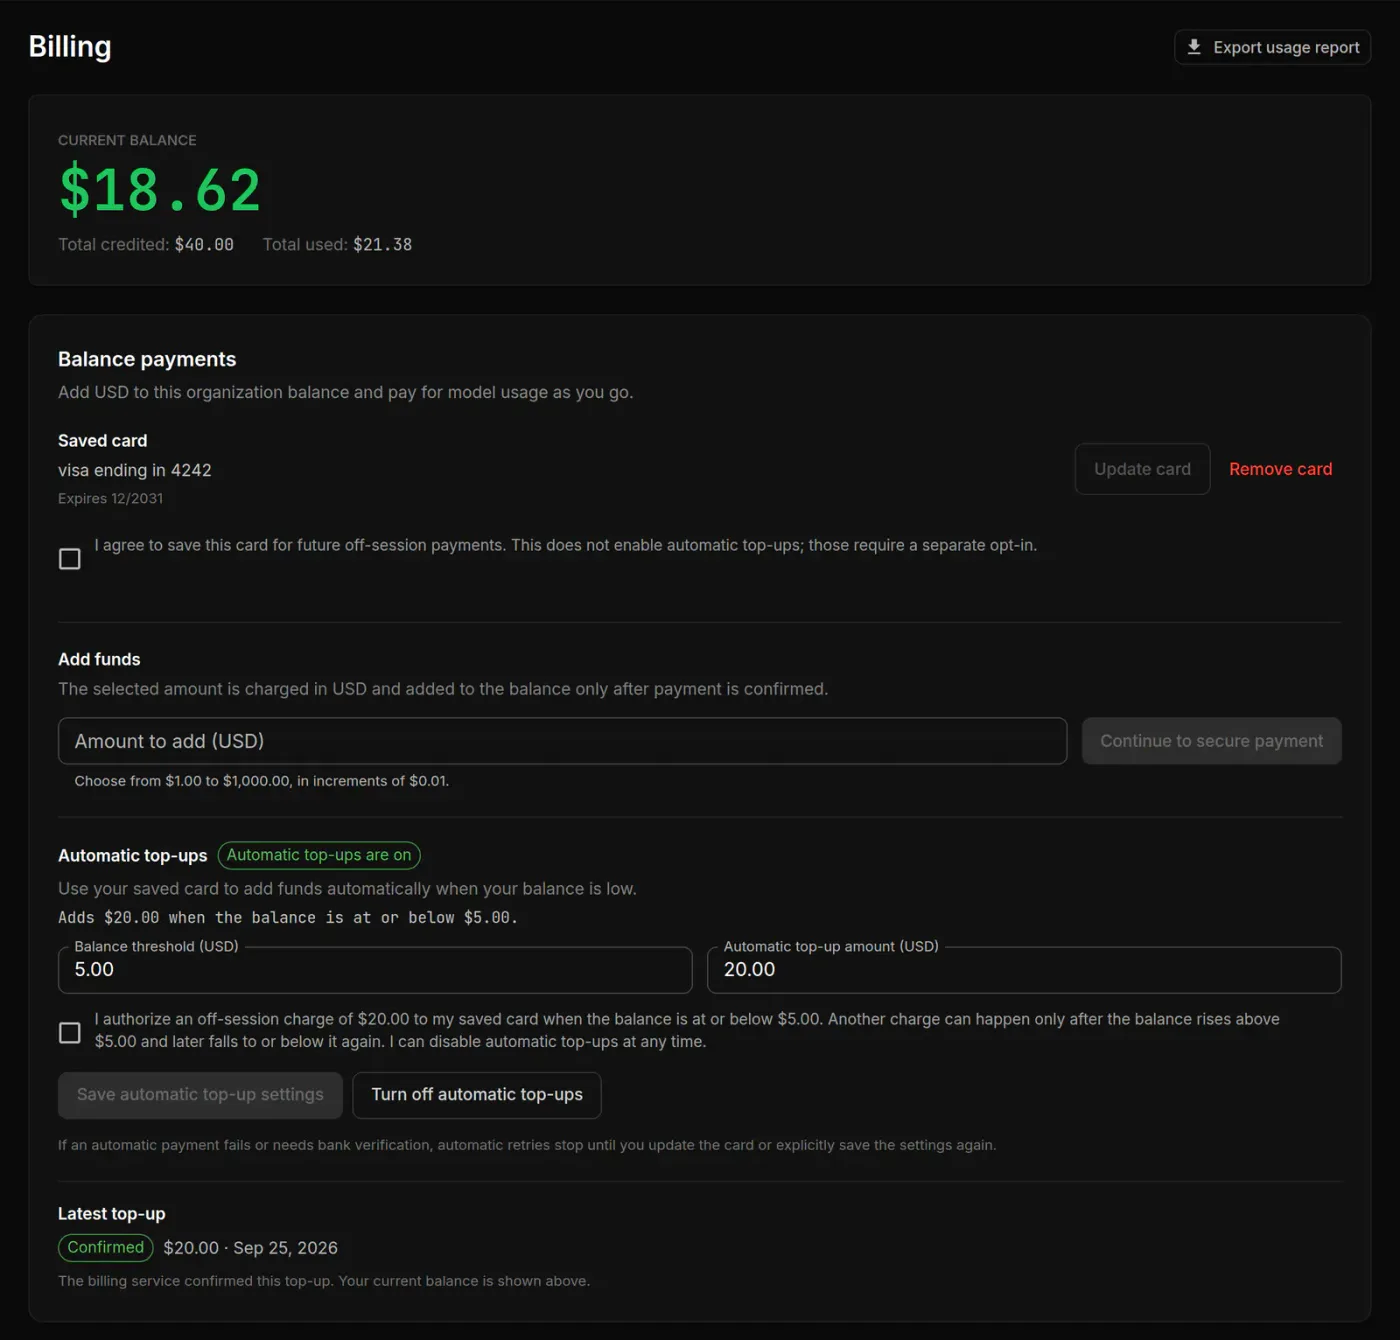
Чат с оплатой по использованию, выбором abliterated-модели и балансом, который пополняется сам. Картинки с submissive-ai.com.
С чего начинали
Red team и профессионалам, которые тестируют AI и работают с ним, нужны модели, которые отвечают на вопрос так, как он задан, без отказов и без переписывания запроса. Для этого нужны abliterated-модели, то есть open-weight-модели со снятым поведением отказов, и модели, дообученные под задачу.
Технически это один из самых сложных видов AI-продукта. Нужны кастомные модели, дообучение, харнесы для проверки и собственный инференс в нескольких странах, где каждый GPU-час стоит денег, пользуются им или нет. Ошибись в архитектуре, и счёт за GPU обгонит выручку.
Что мы сделали
Нанят запустить продукт, запуск за 9 недель
Меня взяли CTO по подписке специально для того, чтобы запустить этот продукт, и от идеи до запуска прошло 9 недель. Я веду команду из четырёх человек и задаю, как она работает.
Система и движок инференса
Я спроектировал всю систему и движок инференса, который обслуживает abliterated-модели. Со своим движком компания платит за вычисления, и никакой другой провайдер не берёт наценку с каждого токена, поэтому наш инференс на 60%+ дешевле, чем у API-провайдеров.
Open-weight и собственные модели
Мы используем готовые open-weight-модели и наши собственные дообученные, а харнесы проверяют и оценивают каждую из них, поэтому модель попадает к клиентам только после того, как доказала своё качество.
Дата-центры в нескольких странах
Инференс работает в наших дата-центрах в нескольких странах мира, и я руковожу подрядчиками, которые их предоставляют. Компания получает мощности по всему миру без собственного отдела инфраструктуры.
Стоимость инференса под контролем, GPU загружены на 80%+
Я оптимизирую стоимость инференса: какая модель где работает, на каком железе и сколько нам стоит каждый ответ. Загрузка GPU держится выше 80%, поэтому счёт за GPU растёт вслед за выручкой, а не обгоняет её.
Overflow- и биллинговые пайплайны
Я строю overflow- и биллинговые пайплайны, чтобы продукт правильно работал с распределёнными дата-центрами инференса. Нагрузка, которую не берёт одна площадка, уходит на другую, а каждый запрос списывается с баланса клиента ровно один раз, так что запросы не теряются и выручка не утекает через пропущенные или двойные списания.
Результат
Работающий AI-продукт на abliterated- и дообученных моделях, запущенный через 9 недель после идеи, со своим движком инференса в дата-центрах нескольких стран. Инференс на 60%+ дешевле, чем у API-провайдеров, загрузка GPU выше 80%, и команда из четырёх человек держит под контролем стоимость инференса и биллинг, а именно на них AI-продукты такого рода обычно и теряют деньги.
Полный кейс · PDF
Submissive AI
Четверо запустили AI-продукт за 9 недель от идеи, на своём инференсе на 60%+ дешевле API-провайдеров
- 01Архитектура системы и движка инференса
- 02Abliterated и дообученные модели: конвейер
- 03Харнесы и оценка моделей
- 04Инференс в дата-центрах нескольких стран
- 05Оптимизация стоимости каждого ответа
- 06Overflow- и биллинговые пайплайны: без потерянных запросов и двойных списаний
Полный кейс Submissive AI
Открытая часть истории на этом заканчивается. Остальное в PDF: архитектура до и после, план переезда, как команда работает с AI-агентами, сколько всё это стоит в эксплуатации и откуда взялась экономия.
Другие истории
Все истории
Хотите, чтобы следующая история была про вашу компанию?
За 30 минут созвона выберем первую задачу, которую стоит отдать AI, и прикинем, сколько она сэкономит.